发布日期:2026-03-17
近日,同创伟业成员企业龙讯旷腾 MatPL在超算互联网核心节点部署的万卡超集群上,成功完成了高达414.7亿原子的液态水分子动力学模拟。所有原子间的相互作用均达到第一性原理级精度,标志着机器学习力场(MLFF)模拟的规模边界再次被大幅刷新——从290亿跃升至414.7亿,向千亿级原子模拟迈出关键一步。
这一规模意味着科学家可以首次在接近真实尺度的体系上,以量子力学精度研究复杂材料、电池界面、生物大分子等前沿问题,为“AI for Science”打开全新可能。
MatPL是一套由龙讯旷腾开发的开源软件包,用于快速生成媲美从头算分子动力学(AIMD)的机器学习力场,并提供了高效的分子动力学模拟接口,使研究人员能够快速获取高精度模拟结果,显著提升研究效率。
核心亮点
1、破纪录:模拟规模达414.7亿原子,是此前公开报道(290亿)的 1.43倍
2、超高效:4096张异构加速卡并行,通信开销仅4.9%,弱扩展效率高达 88%
3、国产之光: 国产软件MatPL+国产超智融合算力,软硬件协同创新,重新定义计算极限
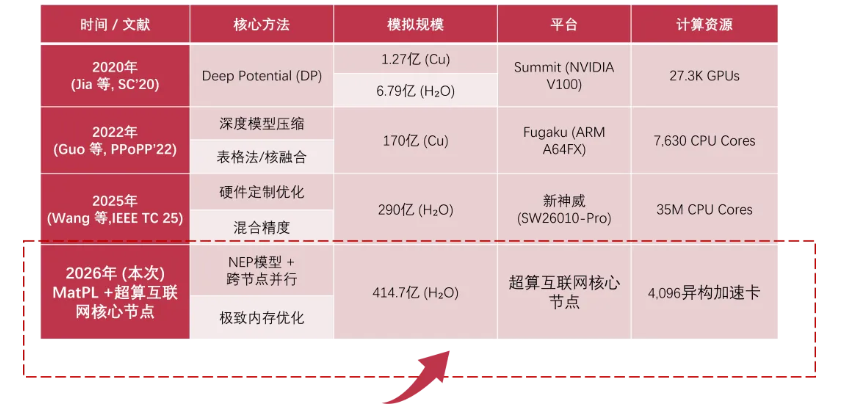
不仅“最大”,而且“最快”
MatPL-2026.3在超算互联网核心节点上展现出惊人的并行效率,我们在4096张异构加速卡上进行了严格的弱扩展测试(每卡负载固定为1012.5万原子),得到近乎完美的弱扩展曲线。
弱扩展曲线
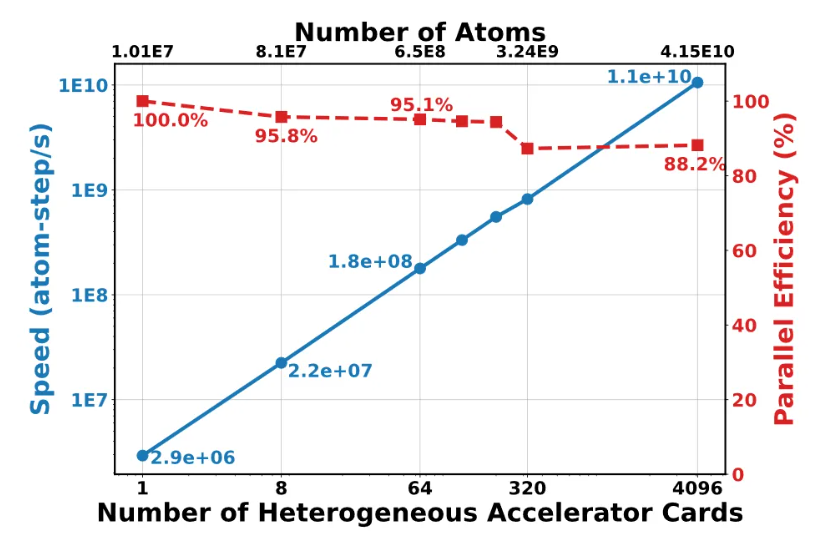
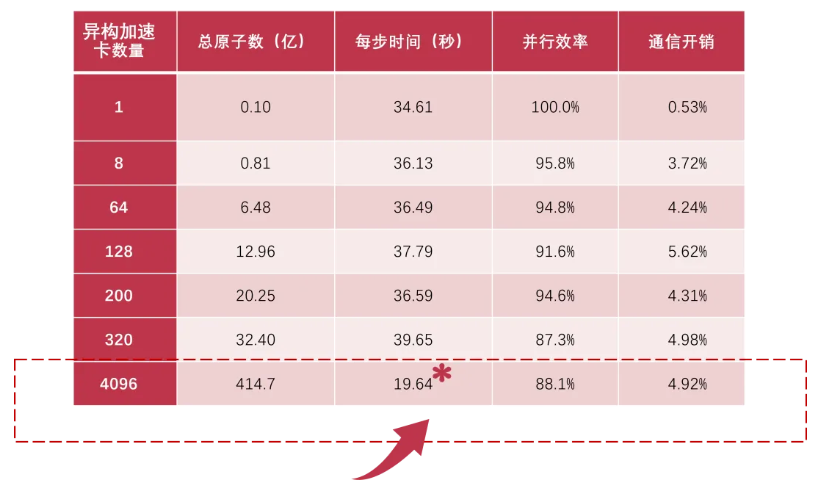
注:4096卡运行500步,其余规模运行10,000步;每步时间为MD单步平均耗时。
极致的通信优化
大规模并行最大的挑战是通信。MatPL通过底层优化,让通信“隐身”:
1、计算占比始终 >90%,每100份算力中90份用于真正的原子计算
2、通信开销始终 <5%,4096卡时仅4.92%,ScaleFabric高速网络游刃有余
这意味着,从单卡到数千卡,MatPL的并行效率几乎没有损失,展现了卓越的软件工程能力。
软硬件协同
国产生态的里程碑
本次破纪录测试基于超算互联网核心节点与MatPL-2026.3软件的深度协同:
1、硬件:超算互联网核心节点部署的曙光scaleX万卡超集群,配备了高性能异构加速卡及高速互联网络,为超大规模并行提供坚实基础;
2、软件:MatPL通过内存优化、近邻表重构、跨节点并行等技术,将硬件的潜力释放到极致;
这是国产软件+国产算力在“AI for Science”领域的又一次历史性握手,证明中国有能力自主构建世界顶级的科学计算生态。
未来已来
通往更广阔的原子世界
414.7亿原子不是终点,而是新起点。MatPL将持续深耕国产计算平台,为更多复杂体系(合金、电池界面、生物大分子)提供兼具第一性原理精度与超大规模扩展能力的分子模拟方案。立即体验 MatPL 的极致性能:
产品手册
http://doc.lonxun.com/MatPL/
开源代码
https://github.com/LonxunQuantum/MatPL
MD接口
https://github.com/LonxunQuantum/lammps-MatPL
北京龙讯旷腾科技有限公司是成立于2015年的国家高新技术企业,是国内材料计算模拟工具软件研发创新的领导者,致力于开发满足“工业4.0”所需的原子精度材料研发Q-CAD(quantum-computer aided design)软件。公司自主开发的量子材料计算软件PWmat可以进行电子结构计算和从头算分子动力学模拟,适用于晶体、缺陷体系、半导体体系、金属体系、纳米体系、量子点、团簇和分子体系等。
官网 :www.pwmat.com
超算云平台:https://mcloud.lonxun.com
视频教程:https://www.lonxun.com/video/
客服微信 :Q-CAD2022
咨询电话:400-618-6006
©2000-2026 Cowincapital ® All Right Reserved 同创伟业集团版权所有
地址:深圳市南山区粤海街道高新南四道88号未来中心A塔45A